

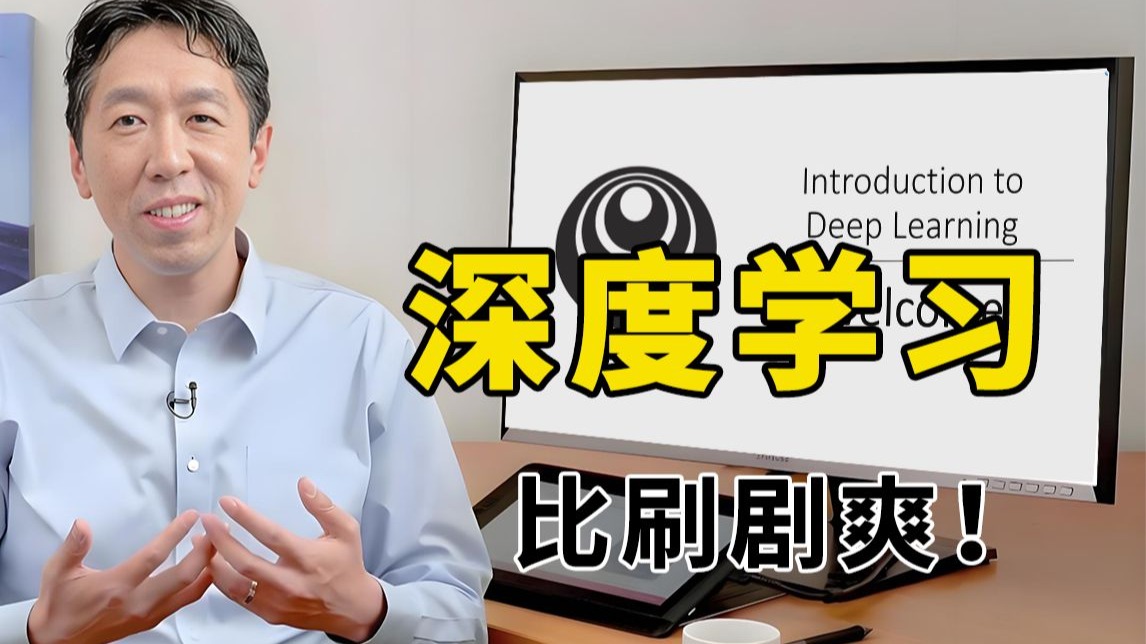
视频元信息
- 课程:吴恩达深度学习专项课程(Deep Learning Specialization)——结构化机器学习项目/职业化深度学习
- 本集性质:选修访谈(Geoffrey Hinton 对话)
- 主题:Geoffrey Hinton 回顾深度学习发展史、核心算法起源、研究心得与给新人的建议
内容摘要(TL;DR)
Geoffrey Hinton 回顾了自己从生理学、物理学、哲学、心理学到 AI 的求学历程,讲述了反向传播(backprop)、玻尔兹曼机、受限玻尔兹曼机、变分方法、ReLU、胶囊网络(Capsule)等工作的来龙去脉,分享了对无监督学习、大脑与反向传播关系、多时间尺度、AI 范式转变的看法,并给出"少读文献、相信直觉、坚持编程"的研究建议。
一、开场与访谈背景 [00:00]
本集为吴恩达(Andrew Ng)对 Geoffrey Hinton 的访谈,属于深度学习专项课程中的选修内容。
注意: 视频开头约 0:00–1:50 的转录文本为语音识别错误产生的乱码,无法还原真实对话内容,本笔记不对该部分做过度解读。
- 访谈主线:Hinton 的学术成长经历、深度学习关键算法的诞生过程、研究哲学与建议。
- 访谈形式:问答式,吴恩达提问,Hinton 回顾与展望。
二、Hinton 的学术历程:从生理学到 AI [01:53]
核心要点: Hinton 的研究兴趣源于对"大脑如何存储记忆"的追问,历经多次学科转向,最终走向 AI。
- 兴趣起点:读到 Lashley 的老鼠大脑实验——切掉老鼠大脑的某些部分后,很难找到某一块专门存储某个特定记忆的区域。这让他第一次对"大脑如何存储记忆"产生兴趣。
- 大学阶段:在剑桥先学生理学与物理学(据他回忆,当时他可能是剑桥唯一同时修这两门课的本科生)。
- 转向哲学:希望哲学能带来更多洞见,但发现哲学缺乏"区分真假"的手段。
- 转向心理学:心理学理论过于简单,无法解释大脑的实际运作。
- 暂时离开学术:去做木匠。
- 转向 AI:前往爱丁堡,师从 Longuet-Higgins 学习 AI。
易错点/重点: Hinton 的导师当时已放弃神经网络、转向符号 AI,认为 Hinton 做的神经网络是"过时的东西",两人因此多次争论。但 Hinton 坚持自己做的东西,最终拿到 AI 博士学位。
- 毕业后在英国找不到工作,申请到加州 Sloan Fellowship,前往加州。
- 关键对比:在英国,神经网络被视为"愚蠢的东西";在加州,Don Norman、David Rumelhart 等人对神经网络持非常开放的态度。
- 在加州与 David Rumelhart 的合作非常愉快,这是他第一次感到"研究大脑如何工作、并与心理学联系起来"被视为正面的事。
理解:这段经历说明学术环境对研究方向的支持度会极大影响研究者的产出与坚持。
三、反向传播算法的诞生与传播 [04:14]
核心要点: 反向传播并非 Hinton 一人独创,但 1986 年 Nature 论文让社区真正接受了它。
- 时间与人物:约 1982 年初,David Rumelhart、Hinton、Ron Williams 共同发展出反向传播算法,主要想法来自 Rumelhart。
- 事后发现多人独立发明:David Parker(可能在他们之后、发表之前)、Paul Werbos(早几年已发表但无人关注),还有其他类似算法。
- 重点: 用链式法则求导本身并不新颖,"反向传播"这个词的含义也不明确。
- 为什么是他们的论文让社区接受?
关键原因: 1986 年他们成功把论文发到 Nature,Hinton 做了不少"政治工作"——他判断审稿人可能是英国著名心理学家 Stuart Sutherland,于是当面长时间向他解释。Sutherland 被一个结果深深打动:反向传播能学到词的表示(word representations)。
- 实验细节:用家庭树(family tree)的小三元组训练,如 "Mary has mother Victoria",给前两个词预测第三个词。
- 训练后,词表示(小向量)中可观察到多种特征:国籍、辈分、在家族树中的分支等。
- 吴恩达点评:这其实是非常早期的 词嵌入(word embedding),语义特征直接从训练算法中涌现。
心理学与 AI 两种知识观的统一
- 心理学观点:概念是一大堆特征的集合(有大量证据支持)。
- 当时 AI 观点(结构主义):概念由它与其他概念的关系定义,需要用图结构或语义网络表示。
- 反向传播实验的意义:把图结构信息(家庭树)输入网络,网络将其转化为特征向量,并能用特征推导出新的一致信息(泛化)。
- 关键: 图表示与特征向量表示之间的双向流动——从图结构能得到特征向量,从特征向量也能得到更多图结构信息。
推导:这实际上预示了后来"分布式表示"与"符号结构"可以互相转换的思想,也是知识表示学习(knowledge representation learning)的雏形。
- 1990 年代初,Bengio 证明可以把同样技术用于真实英文文本,得到真实词的嵌入,影响很大。
四、算力进步的早期信号 [08:30]
核心要点: 深度学习依赖算力,这一趋势在 1980–90 年代就已显现。
- 1986 年 Hinton 用的机器算力不到 0.1 兆弗洛普(megaflops)。
- 到约 1993 年,人们已能用约 10 兆弗洛普,提升约 100 倍。
- 这正是计算机变快、让算法变得"易用"的临界点。
思考:吴恩达指出,人们常谈 GPU 和超级计算机推动深度学习,但早在 1986–90 年代,Hinton 与 Bengio 的工作就已体现这一趋势。
五、Hinton 最引以为傲的三项工作 [09:00]
5.1 玻尔兹曼机(Boltzmann Machine)——最"美"的工作
- 与 Terry Sejnowski 合作。
- 发现一个极其简单的学习算法,适用于大型、密集连接的网络,且只能看到少数节点。
- 能学习隐藏表示(hidden representations)。
- 重点: 算法看起来像大脑中可能存在的机制——每个突触只需知道与它直接相连的两个神经元的行为。
- 两个阶段(称为 wake 和 sleep),但两阶段传播信息的方式完全相同。
- 对比反向传播:有前向传播和反向传播,两者工作方式不同、发送的信号类型也不同。
易错点: 玻尔兹曼机的"美"在于其生物合理性(局部信息、统一传播方式),但多年来因太慢而被视为"奇趣之物"。
5.2 受限玻尔兹曼机(RBM)与深度信念网络
- Hinton 牺牲了一点"美":不让网络完全收敛,只迭代一次,用更简单的网络,得到 受限玻尔兹曼机(RBM),在实践中有效。
- 应用案例:Netflix 竞赛获胜方案中,RBM 是组成成分之一。
- 深度学习的复兴(约 2007 年)与 RBM 工作密切相关。
- 训练方式:训练一层隐藏特征 → 把特征当数据 → 再训练一层 → 反复堆叠。
- 整体可视为单一模型:顶层是 RBM,下面是 sigmoid 信念网络(sigmoid belief net)(Neil 多年前发明),是有向模型。
- 意义:通过训练 RBM,找到了一种在 sigmoid 信念网络中进行高效近似推断的方法。
关键对比(当时的两派):
- 做神经网络的人:用密集连接网络,但没有好的概率推断方法。
- 做图模型的人(如 Michael Jordan):能做正确推断,但只能在稀疏连接网络上。
- Hinton 的贡献:给出学习深度信念网络的方法,使近似推断非常快,只需一次前向传播。
- 并且保证:每多学一层特征,就得到一个更好的下界(bound),新下界总优于旧下界。
5.3 变分方法(Variational Methods)与近似 EM
- 与统计领域早期工作相似,但当时他们并不知道。
- 让 EM 算法工作得更好:不需要完美的 E 步,可以用近似 E 步——这是对 EM 的一大推广。
- 1993 年(约)发表第一篇变分贝叶斯论文:用高斯近似难解项,使贝叶斯学习更可处理,可应用于神经网络。
理解:这三项工作分别对应——生物合理性(玻尔兹曼机)、实用深度学习复兴(RBM)、概率推断理论(变分方法)。
六、ReLU 与初始化:一个被错过的机会 [13:22]
核心要点: ReLU 的流行部分源于 Hinton 组的等价性证明;初始化技巧本可更早引出残差网络。
- 关于 ReLU(修正线性单元):别人也想过,但 Hinton 组用受限玻尔兹曼机证明 ReLU 几乎等价于一叠 logistic 单元,这帮助 ReLU 流行起来。
- 吴恩达问:ReLU 论文里大量数学是否真的影响了 max(0,x) 的发展?
- Hinton 回答:这次数学确实重要。因为玻尔兹曼机的基础工作都用 logistic 单元,问题是学习算法能否用于 ReLU。通过证明 ReLU 几乎等价于一叠 logistic 单元,说明所有数学推导都能走通。
易错点/遗憾: 2014 年 Hinton 到 Google 后做过一个演讲:用 ReLU 并以单位矩阵初始化。好处是——如果不断复制隐藏层并用单位矩阵初始化,网络只是复制输入模式。他展示了可以高效训练 300 层隐藏层的网络。但他没有继续推进,后来非常后悔——因为残差网络(Residual Networks)本质上就是这类东西。他们只发了一篇论文(与 Caglar 合作),展示了可以直接初始化、可以这样初始化循环网络。
思考:这是深度学习史上"差一步就发明 ResNet"的著名轶事,说明好想法若不被坚持推进,可能被他人抢先实现。
七、大脑与反向传播:Hinton 的观点 [16:00]
核心要点: Hinton 认为反向传播在大脑中完全可能实现,神经科学家的"不可信"论调是愚蠢的。
- 主要观点:如果反向传播真是很好的学习算法,进化一定能实现它。
- 类比论证:细胞能变成眼球或牙齿,那它们当然也能实现反向传播,且必然存在巨大的选择压力。
- 因此神经科学家认为"看起来不可信"的说法是愚蠢的。
- 大脑可能有一种不完全等同、但非常接近反向传播的实现。
相关算法与历史
- 1987 年与 Jamie McClelland 提出 Recirculation 算法:让信息在环路中传递,使信息绕环一圈后尽量不变。
- 最简单版本:输入单元 ↔ 隐藏单元反复传递,训练自编码器但不用反向传播。
- 学习规则:权重变化正比于突触前输入,正比于突触后输入的变化率。
- Recirculation 试图让旧的好、新的坏;后来神经科学发现的 STDP(脉冲时序依赖可塑性) 是同一算法但方向相反——新的好、旧的坏。
- 2007 年 Hinton 意识到:训练好一叠 RBM 后,就具备了用"重构"实现反向传播的条件——重构误差实际上给出了判别性能的导数。
- 2007 年 NIPS 第一届深度学习 workshop 上他讲了这一点,几乎被完全忽视。
- 后来 Joshua Bengio 接手这个想法并做了更多工作,Hinton 自己也在继续研究。
- 核心思想:如果有一叠自编码器,可以通过把活动反向传递、观察重构误差来获得导数,这很可能就是大脑的做法。
八、多时间尺度与快速权重 [18:30]
核心要点: 快速权重(fast weights)可承载短期记忆,支持真正的递归。
- 起源:Hinton 研究生第一年第一次演讲就讲了 fast weights——快速适应、快速衰减的权重,可承载短期记忆。
- 1973 年他在一个简单系统中展示了可以用这些权重做真正的递归(true recursion)。
- 真正递归的含义:用于表示事物的神经元在递归调用中被复用,用于表示知识的权重也在递归调用中被复用。
- 关键问题:递归调用弹出时,如何记住递归过程中的状态?答案是把记忆放入 fast weights,再从 fast weights 恢复神经元的激活状态。
- 与 Jimmy Ba 合作,2015/2016 年在 NIPS 发表用 fast weights 做递归的论文。
- 时间跨度:从 1973 年未发表的第一版到 2015/2016 年的模型,相隔约 40 年。
九、胶囊网络(Capsules) [20:30]
核心要点: 胶囊用向量表示多维实体,通过"一致性路由"实现更好的泛化与视角处理。
- Hinton 自嘲又回到"自己坚信、别人不信、论文总被拒"的状态,但会继续推进。
- 关键思想一:如何表示多维实体。
- 只要知道某个区域至多有一个某类特征,就可以用一组神经元的活动表示该特征的不同方面。
- 例如:在一个区域内恰好有一个六边形/坐标,它的朝向、运动速度、颜色、亮度等。
- 用一组神经元表示同一事物的不同维度——这与传统神经网络"一个大层里所有单元各干各的"非常不同。
- 关键思想二:胶囊(capsule)。
- 把表示划分为不同子集,每个子集称为一个胶囊。
- 一个胶囊能表示一个特征的实例,且只能表示一个,同时表示该特征的所有属性。
- 对比:普通神经网络中的神经元只表示一个标量属性。
- 关键思想三:一致性路由(routing by agreement)。
- 场景:有一个"可能是嘴"的胶囊和一个"可能是鼻子"的胶囊,要判断是否应组合成一张脸。
- 让每个胶囊投票决定"脸"的参数应该是什么。
- 如果嘴和鼻子的空间关系正确,它们的投票会一致。
- 重点: 在高维空间中,两个低层胶囊对同一组高层参数投票一致,是非常不可能偶然发生的,因此可认为它们大概率正确。
- 这与传统神经网络滤波方式非常不同。
- Hinton 期望:一致性路由能让神经网络从有限数据中泛化得更好,尤其擅长处理视角变化和分割(segmentation),并比现有方法更高效。
- 训练方式:仍是监督学习,但前向传播机制不同——存在少量迭代(先找到鼻子和嘴,再迭代决定是否组成脸),并且可以对整个迭代过程做反向传播。
- 当前进展:在多伦多的 Google 团队(Brain team 的一部分)推进中。
易错点: 胶囊网络不是纯前向传播,而是带少量迭代的前向过程;它不是无监督方法,仍用监督学习训练。
十、AI 范式转变:从符号到向量 [28:00]
核心要点: Hinton 认为"思维是符号表达式"是 AI 早期的大错误,思维应是大向量。
- 早期(1950 年代):von Neumann 和 Turing 并不相信符号 AI,他们更受大脑启发,但两人都英年早逝,声音未被听到。
- 早期 AI 主流:智能所需的表示是某种符号表达式(类似清理过的逻辑,可做非单调推理),智能的本质是推理。
- 现在的不同观点:重要的是活动的大向量。
- 对比:思维是符号表达式 vs. 思维是大向量。
- Hinton 的论证:
- 输入是字符串,输出是字符串,所以人们以为中间也必须是字符串或类似字符串的东西。
- 但正如理解空间场景不是用像素——像素进来、像素出去,中间不是像素。
- 所以思维不是语言,而是大向量;大向量具有因果能力,能引起其他大向量。
- 这与标准 AI 观点完全不同,但 AI 正在逐渐接受这一新观点(部分接受)。
思考:这一节是理解 Hinton 一生研究哲学的关键——分布式表示(distributed representation)贯穿其所有工作。
十一、无监督学习与生成模型 [25:30]
核心要点: Hinton 长期相信无监督学习是关键,但现实是监督学习在过去十年最成功。
- 1980 年代中期:用反向传播做判别式学习,效果不错。
- 1990 年代初:Hinton 认为人类学习大部分是无监督学习,转向无监督研究(Wake-Sleep 算法等),受 Helmholtz 机影响。
- 长期信念:无监督学习最终会至关重要。
- 但现实:过去十年左右,成功的是监督学习(有标签,或预测序列中的下一个元素作为标签)。
- 现状:包括 Hinton 在内的资深研究者仍对无监督学习兴奋,但几乎没人知道该怎么做。
- Hinton 认为有希望的方向:
- 变分自编码器(VAE):使用重参数化技巧,想法很好。
- 生成对抗网络(GAN):Hinton 认为这是深度学习中最新的重大想法之一。
- 关于稀疏性(sparsity):Hinton 说自己从来不像吴恩达那样看重稀疏性。
- 关于慢特征(slow features):
- Hinton 认为"慢"是错的,基本思想对,但不该追求"不变"的特征,而应追求以可预测方式变化的特征。
- 建模的基本原则:对观测做非线性变换,直到得到一个表示——在这个表示空间中,动作是线性的。
- 不是像常见滤波器那样假装线性,而是真正找到从可观测量到底层变量的变换,使底层变量上的矩阵乘法等线性操作能完成工作。
- 例子:改变视角时,应从像素走到坐标表示,在坐标上做矩阵乘法改变视角,再映射回像素。
- 这正是 Hinton 期望胶囊网络能找到的表示。
重点: "慢特征"应改为"可预测变化的特征"——这是 Hinton 对无监督表示学习的重要修正。
十二、给新人的建议 [31:00]
核心要点: 少读文献、发现别人做错的地方、相信直觉、坚持编程。
12.1 关于读文献
- 建议:读文献,但不要读太多。
- 这是 Hinton 从导师那里得到的建议,与主流"先花几年读文献再开始自己的研究"相反。
- 对创造性研究者:读一点点文献,注意到一件你认为所有人都做错了的事,反其道而行,想出正确做法。
- 当别人说"这不行"时,坚持下去。
- Hinton 的"坚持原则":
- 如果你的直觉好,跟随它,最终会成功。
- 如果你的直觉不好,做什么都无所谓。
- 所以不妨相信自己的直觉。
12.2 关于复现论文
- 吴恩达建议:不要只读,还要复现已发表的论文。
- Hinton 同意:复现论文时,你会发现让它工作所需的各种小技巧。
12.3 永远不要停止编程
重点建议: 永远不要停止编程。
- 差学生:给他任务,回来说"没成功",原因可能是他做了某个小决定,却没意识到什么是关键的。
- 好学生:给他任何东西,回来说"成功了"。
12.4 如何判断想法好坏
- 如果你认为是个非常好的想法,而别人说它是"彻头彻尾的胡说",那说明你可能真的抓住了什么。
- 案例:Hinton 与合作者刚提出变分方法时,把想法解释给前学生 Peter Brown,Peter 又给 Dele Pietro 兄弟看,他们的反应是:"这家伙要么喝醉了,要么就是蠢。"——这恰恰是"好想法"的信号。
12.5 选导师的建议
- 找一个信念与你相似的导师。
- 如果你做导师深信的东西,你会得到大量好建议和时间。
- 如果你做导师不感兴趣的东西,你只能得到一些没用的建议。
12.6 读博 vs. 进公司
- 现状:受过深度学习训练的高校教师不足,大学没有足够师资培养所需人才,但这是暂时的。
- 问题根源:多数院系对正在发生的革命理解太慢。
- Hinton 观点:这不是第二次工业革命,但规模接近。
- 关键变化: 我们与计算机的关系变了——不再是编程计算机,而是向计算机展示(show),让它自己弄明白。
- 计算机科学系是围绕"编程计算机"建立的,不理解"展示计算机"会和"编程计算机"一样重要,不理解系里一半人应该是"通过展示让计算机做事"的人。
- 他的系拒绝承认应该有大量人做这个方向。
- 结果:需要依赖大公司做大量培训,例如 Google 的 Brain Residency 项目。
- 大学最终会赶上。
- 现象:很多顶尖博士项目中,超过一半的申请者想做的其实是"展示"而非"编程"。
十三、MOOC 与 RMSprop 的渊源 [37:30]
核心要点: 吴恩达邀请 Hinton 做 MOOC,催生了 RMSprop 算法。
- 吴恩达指出:据他所知,第一个深度学习 MOOC 是 Hinton 的,2012 年上线,也正是在那时 Hinton 发表了 RMSprop 算法。
- Hinton 回应:那是因为吴恩达邀请他做 MOOC,他本来很犹豫,是吴恩达不断推动他去做,结果很好,虽然工作量很大。
- 吴恩达感谢 Hinton 做了第一个 MOOC,让很多人受益。
背景补充:RMSprop 是一种自适应学习率优化算法,通过除以梯度平方的指数加权平均的平方根来调整每个参数的学习率,至今仍是常用优化器之一。
十四、关键概念速查表
| 概念 | 简要解释 | 视频中提及的背景 |
|---|---|---|
| 反向传播(Backprop) | 用链式法则计算梯度,前向传播+反向传播 | 1982 年 Rumelhart、Hinton、Williams 发展,1986 年 Nature 论文 |
| 词嵌入(Word Embedding) | 把词映射为稠密向量,语义特征自动涌现 | 1986 年家庭树实验,1990 年代初 Bengio 用于真实文本 |
| 玻尔兹曼机 | 基于能量的随机神经网络,学习算法简单、生物合理 | 与 Sejnowski 合作,Hinton 认为"最美" |
| 受限玻尔兹曼机(RBM) | 简化的玻尔兹曼机,一层隐藏层,实践有效 | 深度学习复兴(约 2007)的关键,Netflix 竞赛获胜方案成分 |
| 深度信念网络 | 顶层 RBM + 下层 sigmoid 信念网络,可逐层训练 | 提供高效近似推断,每加一层得到更好下界 |
| 变分方法 / 近似 EM | 用近似 E 步替代精确 E 步,推广 EM | 1993 年第一篇变分贝叶斯论文 |
| ReLU | max(0,x),证明几乎等价于一叠 logistic 单元 | 帮助 ReLU 流行;单位矩阵初始化可训练 300 层 |
| 残差网络(ResNet) | 跳跃连接,可训练极深网络 | Hinton 后悔没继续推进单位矩阵初始化的工作 |
| Recirculation | 信息绕环路传递,训练自编码器不用反向传播 | 1987 年与 McClelland 提出,与 STDP 方向相反 |
| 快速权重(Fast Weights) | 快速适应、快速衰减的权重,承载短期记忆 | 1973 年首次提出,2015/2016 与 Jimmy Ba 发表 |
| 胶囊网络(Capsules) | 用向量表示多维实体,通过一致性路由组合 | Hinton 当前最兴奋的方向,仍在推进 |
| STDP | 脉冲时序依赖可塑性,神经科学发现的学习规则 | 与 Recirculation 是同一算法但方向相反 |
| 变分自编码器(VAE) | 用重参数化技巧训练生成模型 | Hinton 认为是有希望的无监督方向 |
| GAN | 生成器与判别器对抗训练 | Hinton 认为是深度学习最新的大想法之一 |
十五、容易踩坑的点与注意事项
1. 反向传播不是 Hinton 独创: 多人独立发明(Werbos、Parker 等),链式法则求导本身不新颖。论文能发表并影响社区,部分归功于"政治工作"和词表示实验的说服力。
2. 玻尔兹曼机 vs. 反向传播的传播方式: 玻尔兹曼机两个阶段传播方式相同(生物合理),反向传播前向与反向传播方式不同、信号类型不同(生物上较难解释)。
3. 慢特征 ≠ 不变特征: Hinton 明确说"慢"是错的,应追求"以可预测方式变化"的特征。
4. 胶囊网络不是纯前向: 含少量迭代,可对迭代做反向传播,仍是监督学习。
5. 无监督学习尚未成功: 尽管资深研究者都相信它重要,但至今几乎没人知道怎么做。VAE 和 GAN 是有希望的方向。
6. 不要只读文献: 读太多可能扼杀创造力;找到"大家都做错"的点,坚持自己的直觉。
十六、拓展与延伸思考【拓展】
【拓展】Hinton 提到的"用非线性变换找到线性动作空间"的思想,与后来 NeRF(神经辐射场)、世界模型(World Models) 中"在隐空间做线性/可预测操作"的思路一脉相承。
【拓展】胶囊网络的"一致性路由"与 Transformer 的注意力机制 有概念上的相似性:都是让多个低层表示对高层表示进行"投票/加权",但实现方式不同。Hinton 后来在 2017 年发表 Dynamic Routing Between Capsules,2018 年提出 EM Routing。
【拓展】Hinton 对"思维是大向量而非符号"的论断,与 分布式表示假设(distributed representation hypothesis) 和 连接主义(connectionism) 传统一致,也解释了为什么大语言模型的词向量/隐状态能承载语义。
【拓展】"向计算机展示而非编程"的判断,在 2020 年代大模型时代得到验证:提示工程(prompt engineering)、上下文学习(in-context learning)本质就是"展示"。
【拓展】Hinton 与 Jimmy Ba 的 fast weights 工作,与后来 线性注意力(Linear Attention)、状态空间模型(如 Mamba) 中"用快速变化的记忆状态承载短期信息"的思想有相通之处。
【拓展】关于"单位矩阵初始化可训练 300 层"的遗憾,可与 ResNet(2015)、Highway Networks、DenseNet 等跳跃连接工作对照阅读,理解"深度网络可训练性"这一核心问题的演化。
关键标签 / 关键词
深度学习 #GeoffreyHinton #反向传播 #玻尔兹曼机 #受限玻尔兹曼机 #深度信念网络 #变分方法 #EM算法 #ReLU #残差网络 #胶囊网络 #快速权重 #无监督学习 #生成对抗网络 #变分自编码器 #词嵌入 #AI范式 #分布式表示 #吴恩达 #深度学习专项课程 #研究建议 #STDP #Recirculation
生成时间:2026-10-10 21:36:38 生成平台:VideoNote www.xygy.top




